ブートストラップ法は、手元の標本から復元抽出を繰り返し、統計量のばらつきを経験的に求める方法です。母集団の分布を正規と決め打ちできないとき、標本が少ないとき、中央値や比率の差のように「標準誤差の公式がすぐ書けない」推定量を扱うときに使います。
分析の現場では、平均より中央値や「しきい値を超えた割合」を見ることが多いです。公式の \(s/\sqrt{n}\) がそのまま使えない指標ほど、ブートストラップの出番になります。
1. 何を求めたいのか
欲しいのは、点推定そのものより その推定がどれだけ揺れるか です。標本平均 \(\bar{x}\) を出したあと、本当に知りたいのは母平均 \(\mu\) ではなく、\(\bar{x}\) の標本分布です。標本分布の広がりが標準誤差、端を切った区間が信頼区間になります。
平均で、かつ標本サイズが大きく、分布が極端に歪んでいなければ、中心極限定理から
\[ \mathrm{SE}(\bar{x}) \approx \frac{s}{\sqrt{n}} \]
で足ります。困りやすいのは次のようなときです。
- 分布が右に長く、平均が外れ値に引っ張られる
- 見たい量が中央値、相関係数、分位点、比率の差など
- \(n\) が小さく、正規近似の裾を信用しにくい
ブートストラップは、理論上の標本分布を、手元の標本から作り直すことでこの隙間を埋めます。
2. 考え方:標本を母集団の代理にする
母集団から何度も標本を取り直せば、統計量の分布は実験で描けます。実際には母集団は見えず、観測は 1 セットだけです。Efron の発想は単純で、いま持っている標本を母集団の代理とみなし、そこから同じサイズを復元抽出する、というものです。
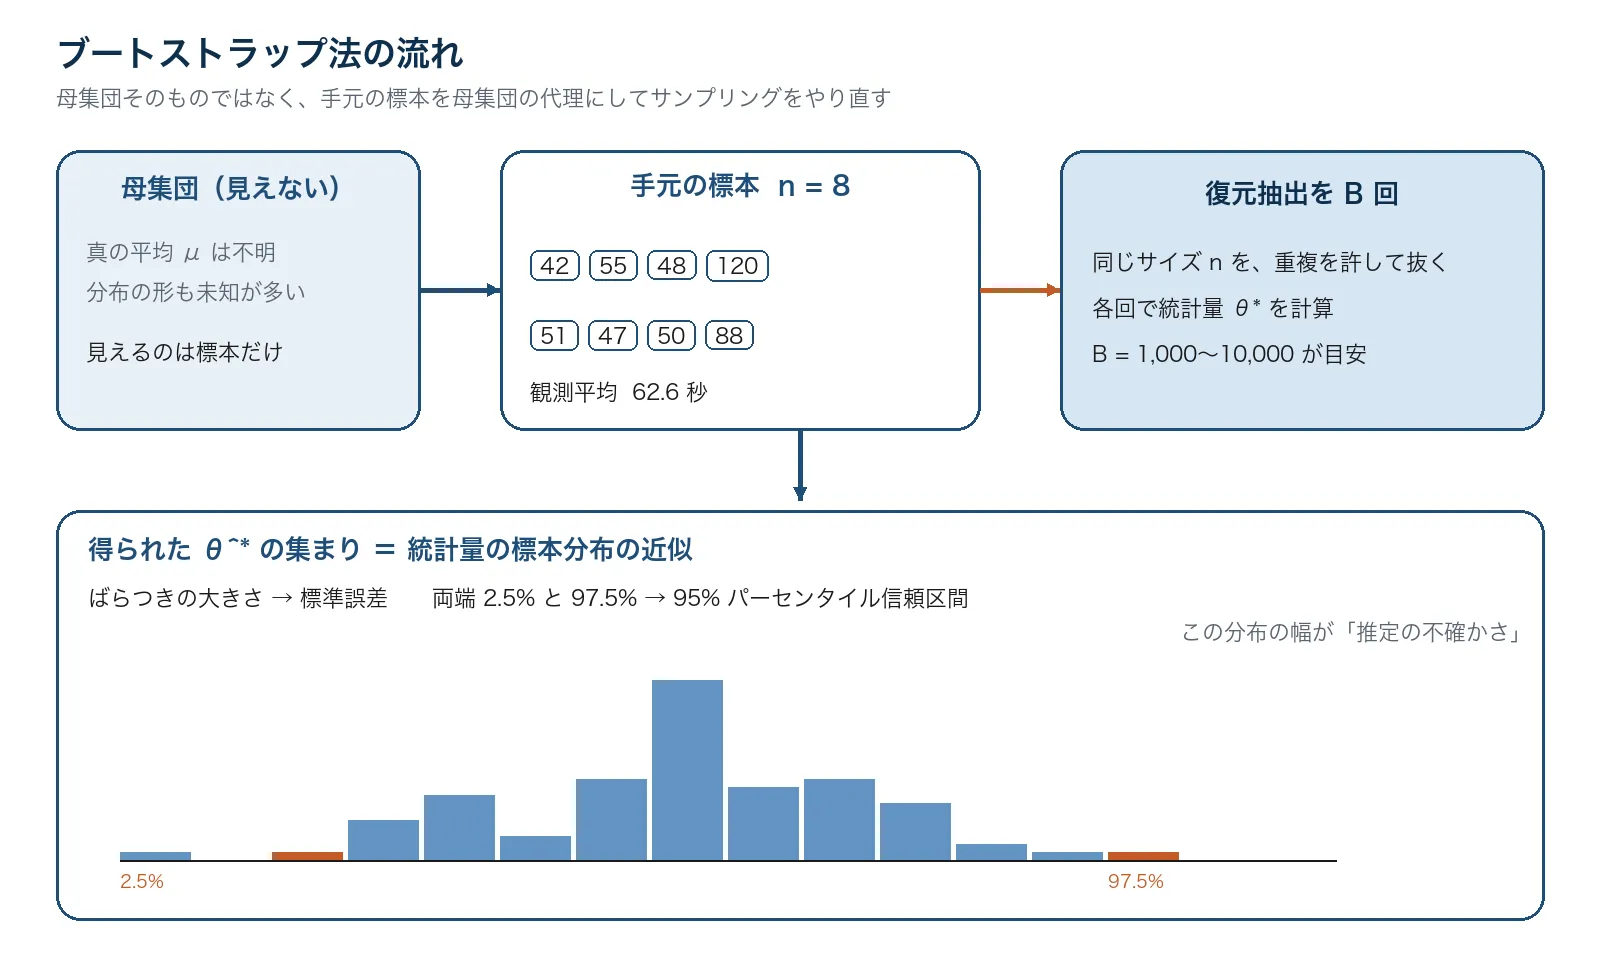
代理がうまくいく条件は、標本が母集団をそれなりに代表していることです。偏った取り方の標本を何万回リサンプリングしても、偏りは消えません。ブートストラップが減らすのは 分散(ゆらぎ)の見積もり誤差 であって、標本の偏りそのものではありません。
ノンパラメトリック・ブートストラップ
分布の形を仮定せず、観測値そのものを等確率 \(1/n\) で復元抽出する。この記事の本体はこちらです。分布を決めて乱数を振る方法は、あとでパラメトリックとして対比します。
3. 手順
やることは 4 つです。
- 大きさ \(n\) の標本 \(x_1,\ldots,x_n\) を取る
- 同じ大きさ \(n\) を 復元抽出 し、ブートストラップ標本 \(x^{*}\) を作る
- 同じ統計量 \(\hat{\theta}^{*}\) を計算する
- 2〜3 を \(B\) 回繰り返し、\(\hat{\theta}^{*}_1,\ldots,\hat{\theta}^{*}_B\) の分布を標本分布の近似とする
標準誤差の推定量は、この経験分布の標準偏差です。
\[ \widehat{\mathrm{SE}}_{\mathrm{boot}} = \sqrt{\frac{1}{B-1}\sum_{b=1}^{B}\bigl(\hat{\theta}^{*}_{b}-\bar{\theta}^{*}\bigr)^{2}} \]
\(B\) は標準誤差だけなら 1,000 程度でも動きます。信頼区間の端(2.5% 点や 97.5% 点)を見るなら 5,000〜10,000 を目安にします。端の分位点は、中央より標本数が要ります。
復元抽出が本体です。非復元にすると、ほぼ同じ 8 人の並べ替えになってゆらぎを過小評価します。実装で replace=False のまま走らせてしまう事故は、実際に見ます。
4. 具体例:滞在時間 8 件
マーケの現場でありがちな設定です。ある LP の滞在時間(秒)が、まだ 8 セッション分しかありません。
\[ 42,\ 55,\ 48,\ 120,\ 51,\ 47,\ 50,\ 88 \]
平均は \(62.6\) 秒、中央値は \(50.5\) 秒です。\(120\) が平均を上へ引き、分布は右に歪んでいます。この平均を「だいたい 63 秒」と言ってよいか、幅を付けたい、というのが問いです。
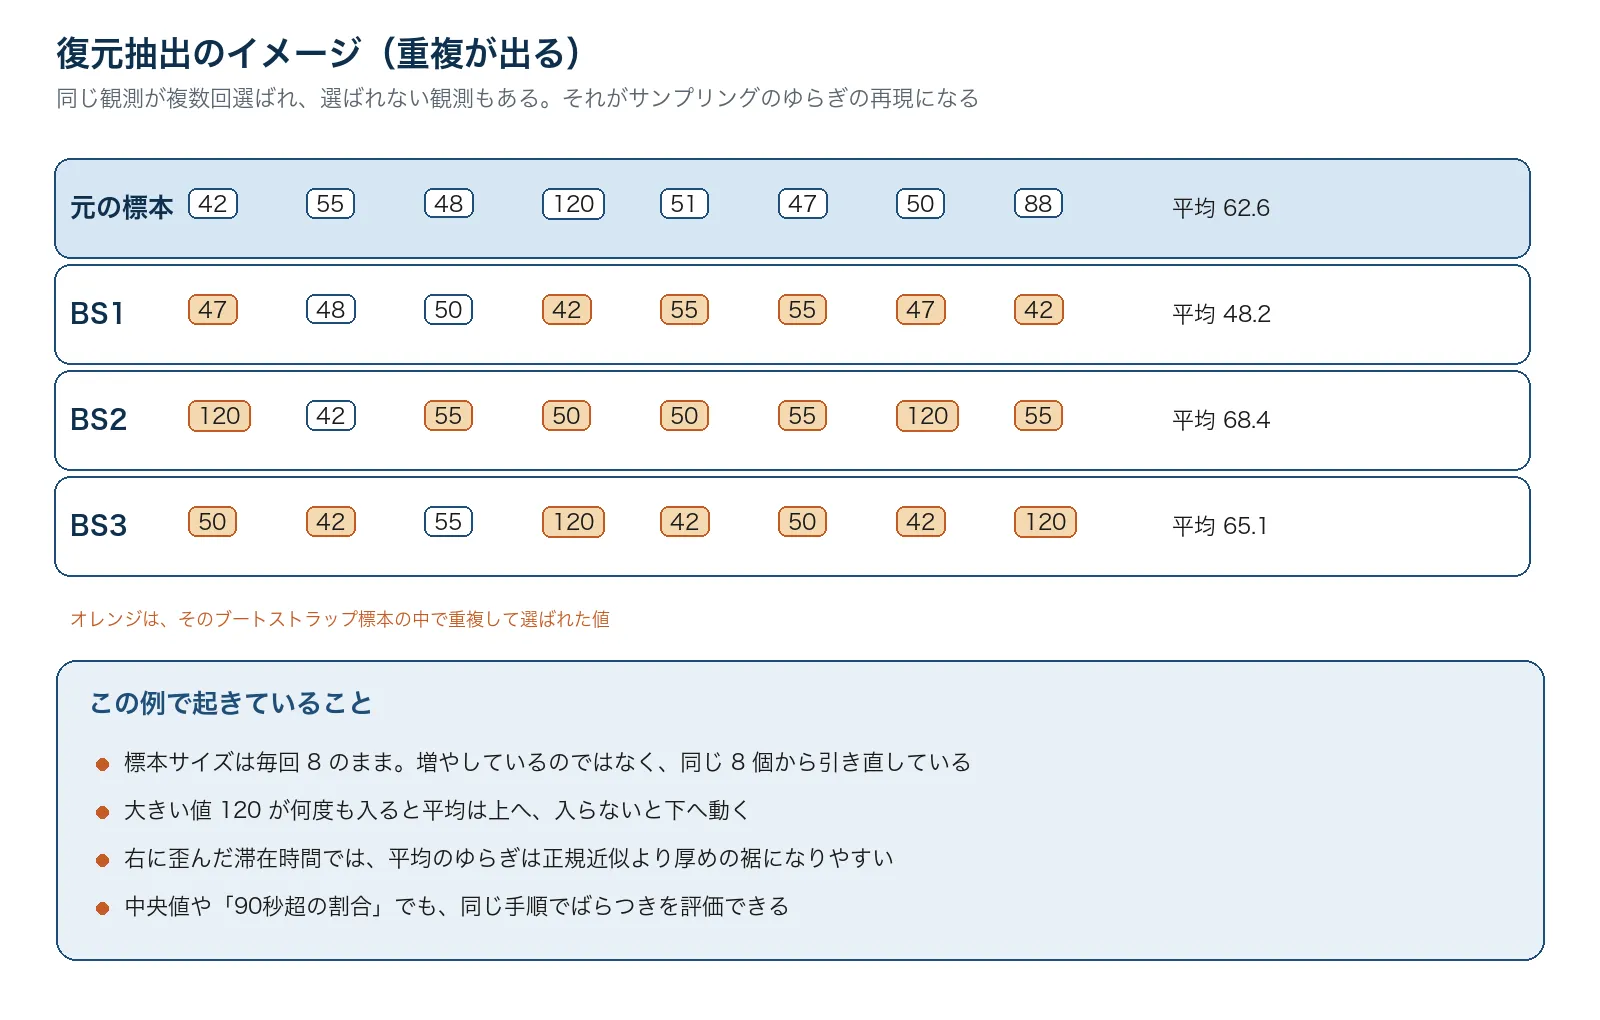
3 回だけ抜き出すと、平均は 48.2、68.4、65.1 とすでに動きます。\(120\) が 2 回入った回は平均が上がり、入らなかった回は下がります。ブートストラップは、この引き直しを何千回もやって分布にする、ということです。
同じ手順は平均専用ではありません。中央値でも、「90 秒超の割合」でも、各ブートストラップ標本で同じ量を計算するだけです。
5. 標準誤差とパーセンタイル信頼区間
同じ 8 件を 5,000 回復元抽出すると、標本平均の分布は次のようになります。
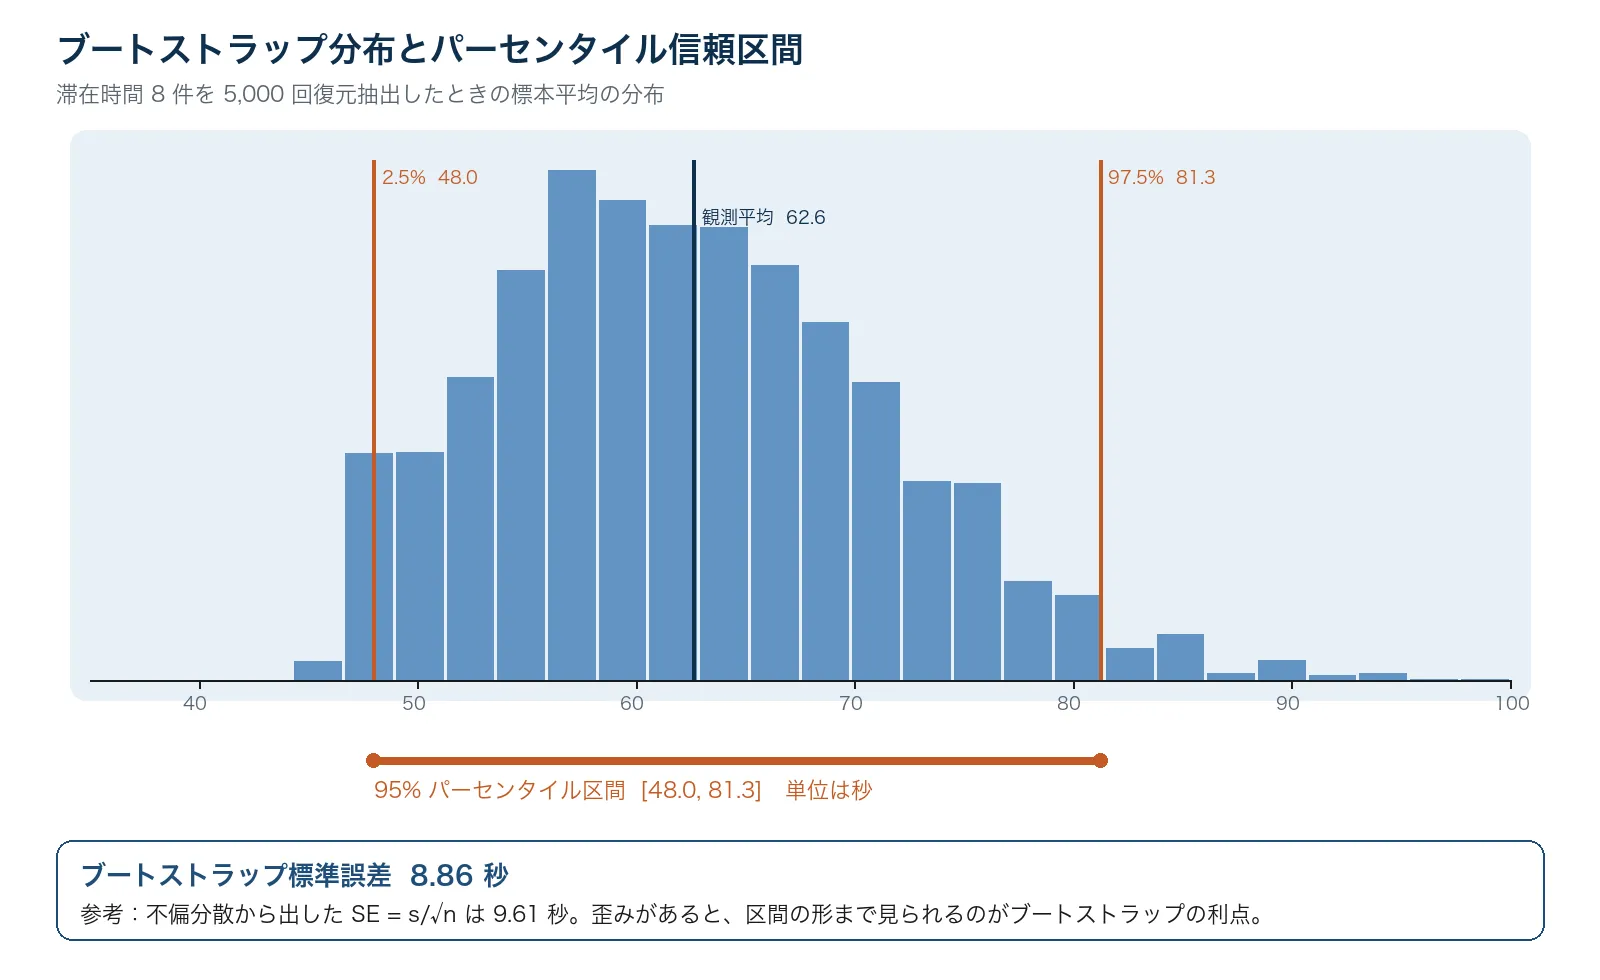
この例では、ブートストラップ標準誤差は約 \(8.9\) 秒でした。不偏分散から出した \(s/\sqrt{n}\) は約 \(9.6\) 秒で、大きくは外れません。違うのは、区間の形までデータから出ていることです。右裾が少し厚いので、区間も上側が広めです。
95% パーセンタイル区間は、ブートストラップ標本の \(2.5\%\) 点と \(97.5\%\) 点です。
\[ \bigl[\hat{\theta}^{*}_{(0.025)},\ \hat{\theta}^{*}_{(0.975)}\bigr] = [48.0,\ 81.3] \]
「この区間に真の平均が入る確率が 95%」ではありません。同じ調査を何度もやり直したとき、この作り方の区間が真値をカバーする割合がおよそ 95%、という話です。1 回きりの分析では、幅の目安として使います。
レポートで「95% の確からしさで平均は 48〜81 秒」と書くと、信用区間の解釈になっています。頻度論の区間はカバー率の話なので、経営層向けには「同じ取り方を繰り返したときの揺れの幅」と説明しています。
推定量に偏りがあるとき、単純なパーセンタイルはズレます。その補正が BCa 区間ですが、まずは上の作り方が分かれば十分です。平均の普通の区間推定との対応は、次の記事が先に読めます。
6. うまくいかないとき
ブートストラップは万能ではありません。実務で壊れるパターンは、だいたい次です。
独立でない。 同じユーザーが複数セッションを持つのに、セッション単位でリサンプリングすると、標準誤差が細くなりすぎます。依存の単位(ユーザー、店舗、日付)でまとめて抜く必要があります。時系列ならブロック・ブートストラップ、という話になります。
標本が母集団を代表していない。 広告経由のヘビーユーザーだけが計測対象、などです。何度抜き直しても、見えていない層は出てきません。
極端に小さい \(n\)。 8 件は説明用です。外れ値が 1 個だと、その値が入るか入らないかで分布が飛びます。ブートストラップは \(n\) を増やしてはくれません。
統計量が滑らかでない。 最大値や、ごく端の分位点は、リサンプリングしても元の端の値ばかりが顔を出します。中央値や平均の方が安定します。
AB テストで変換後の指標や中央値の差を見るとき、ユーザー単位でリサンプリングしています。クッキーやセッションで抜くと「有意に見える」が、集計単位をユーザーに戻すと区間が広がる、というパターンが何度かありました。
7. パラメトリックとの違い
ここまでがノンパラメトリックです。観測値そのものを再抽出します。
パラメトリック・ブートストラップは、先に分布を仮定します。たとえば滞在時間が対数正規だと決めてパラメータを推定し、その分布から乱数を \(n\) 件ずつ生成して統計量を計算します。仮定が当たっていれば分散は安定しますが、仮定が外れるとそのまま歪みます。
迷ったら、まずノンパラメトリックです。分布を置く必然がある(階層モデル、欠測、生成モデルの確認)ときにパラメトリックへ進みます。旧稿で扱っていた逸脱度の差の検定は、このパラメトリック側の応用です。考え方は同じで、「帰無の世界からデータを作り直して、観測された差がどれだけ珍しいかを見る」です。
8. 機械学習での使い方
予測モデルでは、同じ復元抽出が バギング になります。ブートストラップ標本ごとにモデルを学習し、分類なら多数決、回帰なら平均します。個々の木の分散を、平均で薄める、という使い方です。
平均の分散は、ざっくり
\[ \mathrm{Var}(\bar{x}) = \frac{1}{B}\mathrm{Var}(x_b) + \frac{B-1}{B}\,\mathrm{Corr}(x_b,x_{b'})\,\mathrm{Var}(x_b) \]
と分解できます。回数 \(B\) を増やすと第 1 項は落ちますが、第 2 項の相関は残ります。木同士が似ていると、バギングの効きは頭打ちです。ランダムフォレストは、分割に使う特徴量までランダムにすることで、この相関を下げます。
ここでは「分散を平均で潰す」という一点だけ押さえて、詳細は次へ渡します。
9. まとめ
- ブートストラップ法は、手元の標本を代理母集団にして 復元抽出 し、統計量の標本分布を経験的に作る方法
- ばらつきの大きさが標準誤差、両端を切るとパーセンタイル信頼区間
- 公式の \(s/\sqrt{n}\) が使いにくい量(中央値、歪んだ平均、比率の差)で特に効く
- 独立でないデータ、偏った標本、極端に小さい \(n\) では、回数を増やしても救えない
- 機械学習のバギングは、同じ復元抽出を学習データに使ったもの
コードの書き方より、何を母集団の代理にして、どの単位で抜き直しているか を先に決める方が重要です。そこがずれると、きれいな区間が出ても意思決定には使えません。